ADN humain : le code qui nous construit
Découvrez l’ADN humain, les gènes, l’hérédité et CRISPR : maladies génétiques, évolution et limites de ce que les gènes peuvent déterminer.
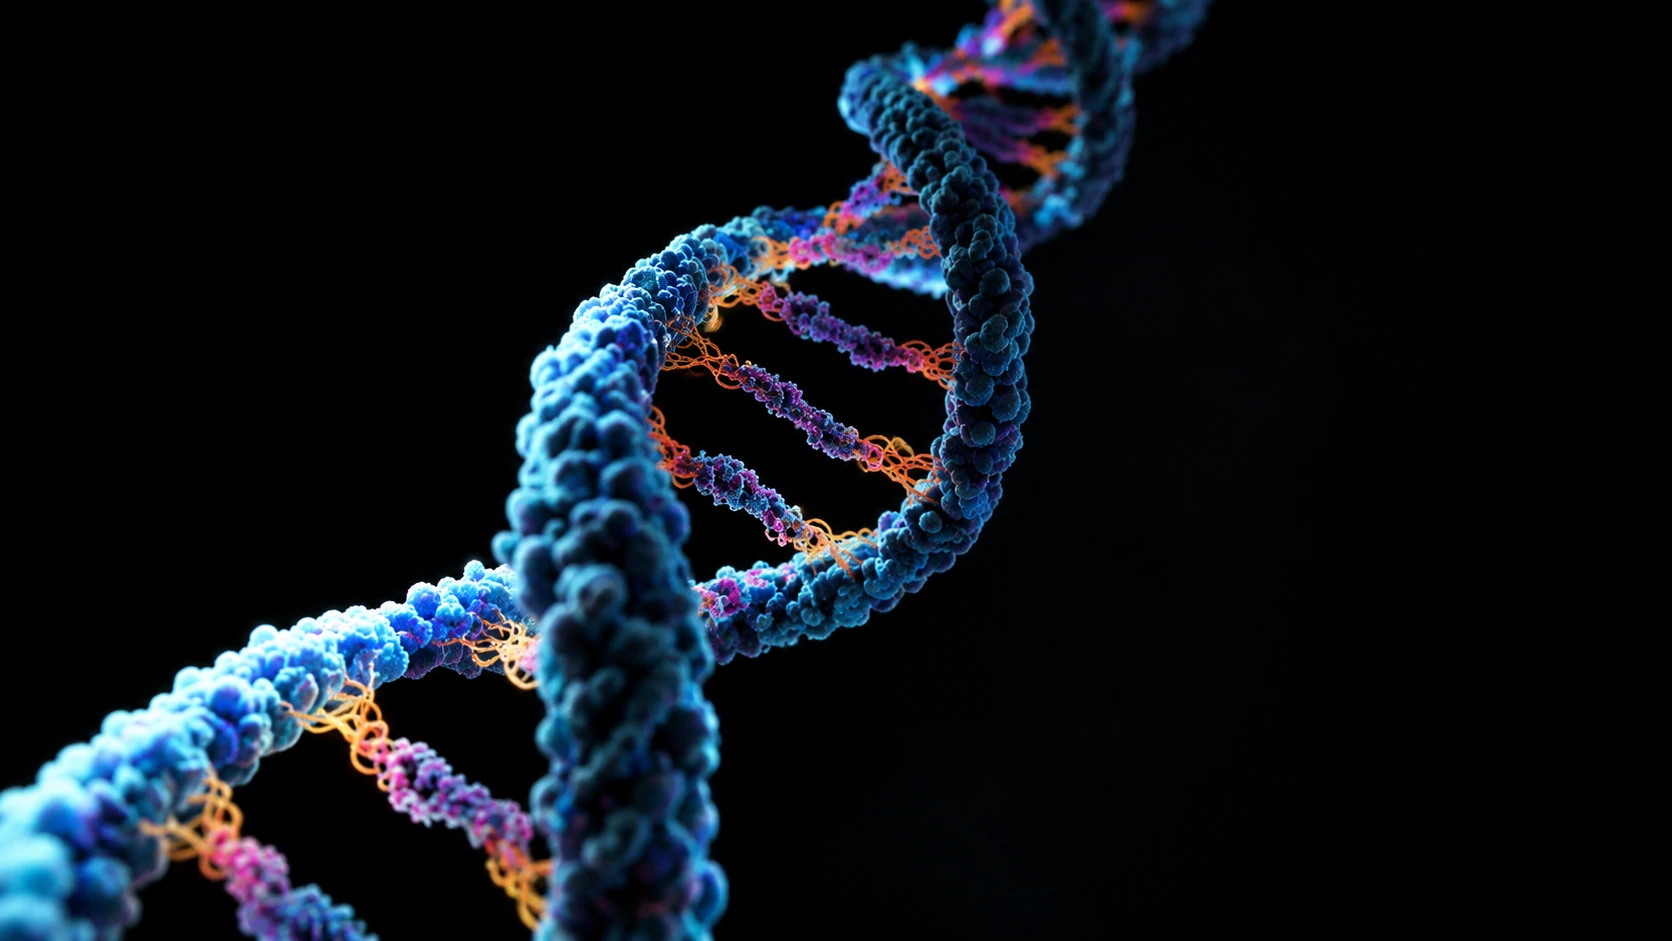
Image principale : illustration scientifique générée par IA pour PRESDA. Double hélice conceptuelle, et non photographie au microscope ou détermination d’une structure moléculaire.
Chaque fois qu’une plaie se referme, qu’un enfant grandit ou qu’une cellule immunitaire se multiplie, des informations moléculaires sont copiées et interprétées. L’ADN, ou acide désoxyribonucléique, conserve l’information héréditaire que les cellules utilisent pour fabriquer des molécules fonctionnelles et réguler leurs processus biologiques. Sa séquence relie la chimie d’une cellule à l’histoire d’une famille et, plus loin encore, à l’évolution du vivant.
Mais l’image familière d’un plan de construction mérite quelques précautions. Un génome ne contient ni une personne miniature ni le scénario complet de sa vie. Le développement dépend de la communication entre cellules, de la régulation des gènes, de l’arrivée des nutriments et des changements de milieu. Comprendre l’ADN, c’est reconnaître à la fois la puissance de l’information héritée et les limites d’une vision qui réduirait un être humain à une suite de lettres.
Qu’est-ce que l’ADN, et pourquoi sa forme compte-t-elle ?
L’ADN est une longue molécule composée de nucléotides. Chacun comprend un sucre, un groupement phosphate et une des quatre bases : adénine, thymine, cytosine ou guanine, désignées par A, T, C et G. Deux brins s’enroulent généralement l’un autour de l’autre pour former une double hélice. Leurs squelettes sucre-phosphate sont orientés en sens opposés, tandis que les bases s’apparient à l’intérieur : A avec T, C avec G. Leur ordre porte l’information biologique. Leur complémentarité permet à chaque brin de servir de modèle pour construire son partenaire. Source: genome.gov
Cette hélice n’est ni une échelle rigide ni une structure lumineuse comme dans une illustration éditoriale. Dans les cellules, elle se courbe, se tord, interagit avec des protéines et devient accessible à certains endroits et à certains moments. Des interactions chimiques la stabilisent tout en permettant son ouverture. Cette alliance entre stabilité et accessibilité explique son efficacité comme support d’information. L’information doit être conservée, mais aussi lue. Une séquence définitivement inaccessible à la machinerie cellulaire serait biologiquement inutile, même si elle était parfaitement préservée.
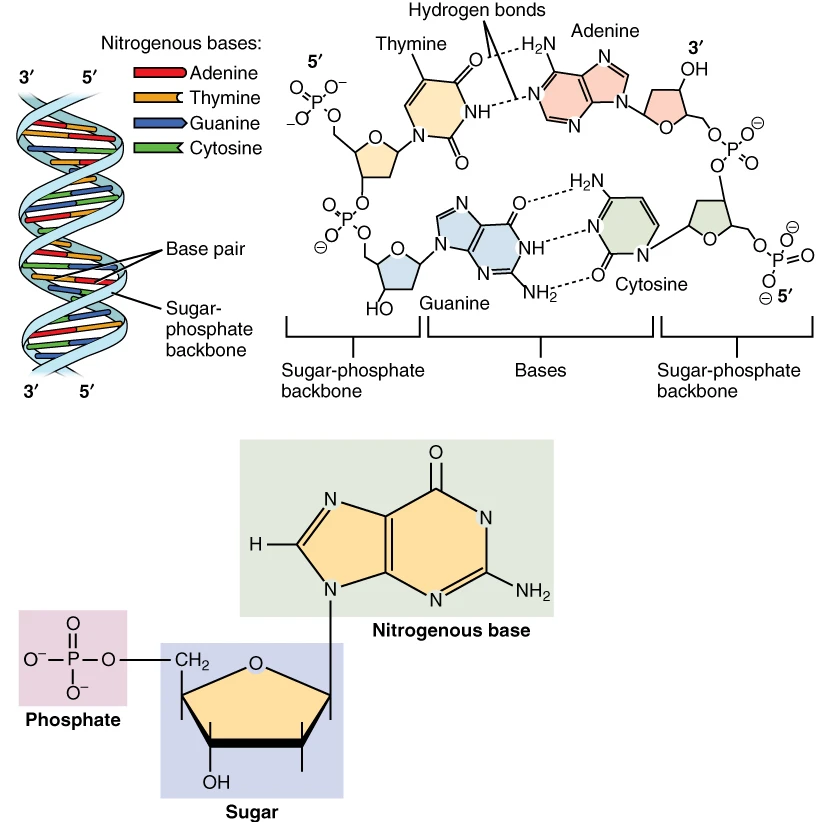
Structure de l’ADN, OpenStax Anatomy and Physiology (2016). Le schéma montre les bases complémentaires et le squelette sucre-phosphate. Schéma pédagogique publié, pas une image microscopique ; légendes anglaises originales conservées.
OpenStax, Anatomy and Physiology (2016) · Image originale et crédit
Conversion WebP et redimensionnement adaptatif par PRESDA. Composition intégrale préservée.
Licence: CC BY 4.0Comment la science a appris à lire cette molécule
La découverte de la structure de l’ADN fut une réalisation collective, pas l’invention de l’ADN lui-même. En 1953, James Watson et Francis Crick proposèrent le modèle de la double hélice. Les travaux de diffraction des rayons X de Rosalind Franklin et Maurice Wilkins apportèrent des éléments structuraux essentiels, aux côtés d’autres résultats chimiques. Le modèle expliquait notamment comment l’appariement complémentaire pouvait permettre la copie de l’information héréditaire. Rappeler ces expériences donne une image plus juste de la découverte qu’un récit d’intuition soudaine détachée de ses preuves. Source: genome.gov
Les découvertes suivantes ont transformé une structure en information lisible. Le séquençage détermine l’ordre des bases sans révéler automatiquement la fonction de chaque portion. Les instruments modernes lisent un nombre immense de fragments d’ADN ; les méthodes informatiques assemblent ou alignent ces lectures et repèrent leurs différences. Les régions répétées, les erreurs techniques et l’interprétation restent des difficultés importantes. La révolution n’a donc pas seulement consisté à mieux voir une molécule. Elle a permis de comparer des séquences, de relier des changements à des effets biologiques et d’aborder des questions auparavant inaccessibles. Source: genome.gov
Gènes, chromosomes et dimensions d’un génome
Un gène est une séquence d’ADN dont l’expression produit un élément fonctionnel, souvent une protéine ou une molécule d’ARN. Un chromosome est un ensemble beaucoup plus vaste d’ADN et de protéines associées, comprenant de nombreux gènes et d’autres séquences. La plupart des cellules humaines nucléées possèdent normalement 46 chromosomes organisés en 23 paires, un jeu provenant de chaque parent. Les ovules et les spermatozoïdes en portent normalement 23. Les globules rouges matures n’ont pas de noyau : l’affirmation selon laquelle chaque cellule contient un génome nucléaire complet admet donc des exceptions. Source: medlineplus.gov
Un jeu de chromosomes nucléaires humains représente environ trois milliards de paires de bases. Une cellule diploïde ordinaire en contient donc approximativement le double avant la réplication. L’être humain possède autour de 20 000 gènes codant des protéines, et non un gène pour chaque caractéristique. Les mitochondries, compartiments impliqués dans le métabolisme énergétique, possèdent aussi un petit génome qui fonctionne avec de nombreux gènes nucléaires. L’ADN mitochondrial est habituellement transmis par la mère. Taille du génome, nombre de chromosomes et complexité biologique sont des mesures différentes, pas une échelle du progrès des organismes. Source: genome.gov
L’emballage de l’ADN a lui-même une fonction. L’ADN nucléaire s’enroule autour de protéines histones et forme la chromatine, dont l’organisation contribue à contrôler l’accès aux séquences. Le chromosome en X représente une forme condensée et répliquée visible autour de la division cellulaire, pas l’aspect permanent de tous les chromosomes. Ses deux chromatides sœurs contiennent des copies d’ADN, tandis qu’une paire chromosomique réunit les chromosomes correspondants d’origine maternelle et paternelle. Confondre ces relations complique la compréhension de l’hérédité. Ce conditionnement permet de gérer, protéger, copier et utiliser de très longues molécules. Source: genome.gov
La majeure partie de l’ADN ne code pas directement des protéines
Une petite fraction du génome humain, environ un à deux pour cent selon les définitions, code directement des séquences protéiques. Le reste n’est pas une catégorie uniforme. Il comprend des régions régulatrices, des gènes produisant des ARN fonctionnels, des introns éliminés de nombreux transcrits, des répétitions et des structures importantes pour l’organisation chromosomique. Certaines fonctions sont bien établies ; d’autres régions restent mal comprises ou sans preuve d’une fonction spécifique sélectionnée. Qualifier tout l’ADN non codant d’inutile est inexact, mais affirmer que chaque base possède une fonction essentielle dépasse également les preuves. Source: medlineplus.gov
Prenons un gène produisant une protéine utile. Fabriquer cette protéine dans le mauvais tissu, au mauvais stade du développement ou en quantité inadaptée peut néanmoins être nocif. L’ADN régulateur contribue à contrôler ces circonstances. Un variant situé hors d’une région codante peut donc affecter la santé en modifiant l’utilisation du gène plutôt que la séquence de sa protéine. Comprendre un génome exige d’étudier ses produits moléculaires autant que les systèmes qui contrôlent leur fabrication. Lire seulement les instructions protéiques laisse une grande partie de la régulation dans l’ombre. Source: medlineplus.gov
Réplication : copier un génome sans repartir de zéro
Avant de se diviser, une cellule somatique typique copie son ADN. Les brins se séparent et servent chacun de modèle à un nouveau brin complémentaire. Des enzymes appelées ADN polymérases construisent les copies ; d’autres protéines ouvrent l’ADN, fournissent les points de départ et réunissent les fragments. Les brins étant orientés en sens opposés, leur synthèse diffère : l’un peut être prolongé en continu au niveau de la fourche de réplication, l’autre est assemblé en courts segments. Chaque double hélice obtenue contient un ancien brin et un nouveau : c’est la réplication semi-conservative. Source: genome.gov
La copie est remarquablement fidèle, mais pas infaillible. La relecture des polymérases et les mécanismes de réparation corrigent de nombreuses erreurs. Des lésions peuvent aussi survenir entre les divisions, lors de réactions chimiques ordinaires ou d’expositions environnementales. Il faut distinguer dommage et mutation : le premier est une lésion chimique, la seconde un changement durable de séquence. Les cellules peuvent réparer les dégâts, cesser de se diviser ou mourir ; toute lésion ne devient pas une modification transmissible. La continuité biologique repose sur un entretien actif, pas sur une molécule invulnérable à l’usure. Source: ncbi.nlm.nih.gov
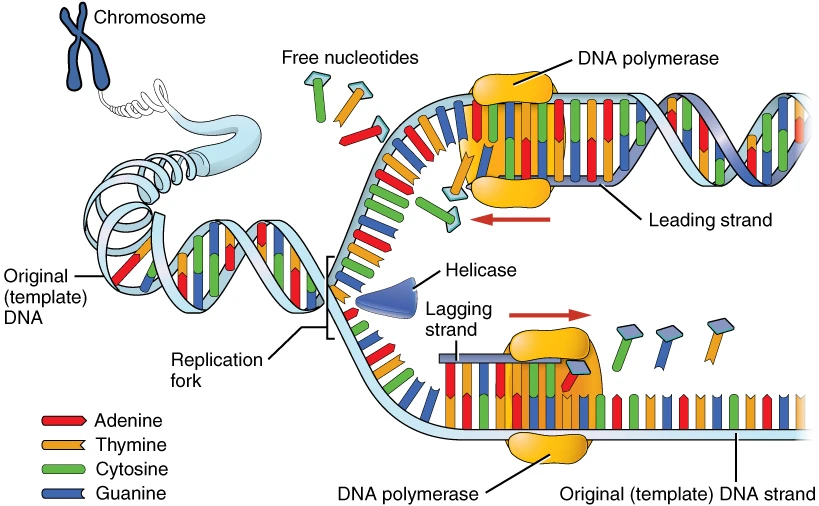
Fourche de réplication simplifiée, OpenStax Anatomy and Physiology (2016). L’hélicase sépare les brins et les ADN polymérases construisent les copies complémentaires. Schéma pédagogique sans échelle moléculaire ; légendes anglaises originales conservées.
OpenStax, Anatomy and Physiology (2016) · Image originale et crédit
Conversion WebP et redimensionnement adaptatif par PRESDA. Composition intégrale préservée.
Licence: CC BY 4.0Expression des gènes : une bibliothèque, plusieurs lectures
Une cellule hépatique et un neurone peuvent contenir pratiquement le même ADN nucléaire tout en accomplissant des tâches très différentes. L’expression des gènes explique largement cette différence. La transcription produit une copie d’ARN à partir de l’ADN. Pour les gènes codant des protéines, l’ARN messager maturé est lu par les ribosomes, qui assemblent des acides aminés. Les codons, groupes de trois bases de l’ARN, désignent un acide aminé ou un signal d’arrêt. D’autres gènes produisent des ARN fonctionnant sans traduction. L’ADN ne construit pas lui-même un muscle et ne transmet pas directement une pensée : des systèmes cellulaires utilisent son information. Source: medlineplus.gov
L’expression est régulée à plusieurs étapes, notamment la transcription, la maturation des ARN et la production protéique. Des facteurs de transcription se fixent sur certaines régions d’ADN, sous l’influence de signaux provenant d’autres cellules. L’épissage alternatif permet à certains gènes de produire différentes formes d’ARN, ce qui explique pourquoi compter les gènes ne décrit pas toute la diversité des produits cellulaires. Le développement repose sur ces réseaux d’interactions. Le cerveau dépend à la fois de l’activité génétique, de l’organisation cellulaire et de l’expérience. La séquence d’ADN contribue à l’explication, sans s’y substituer. PRESDA : cerveau humain Source: medlineplus.gov
Épigénétique : réguler sans réécrire les lettres
L’épigénétique étudie des changements d’activité des gènes associés à des mécanismes qui ne modifient pas la séquence d’ADN. Des modifications chimiques de l’ADN et des histones influencent l’accessibilité des régions à la machinerie cellulaire. Certains profils se maintiennent lors des divisions, aidant une cellule spécialisée à conserver son identité. Ces mécanismes sont essentiels au développement et interviennent dans des maladies. Ce n’est pas une couche mystérieuse au-dessus de la biologie, mais un ensemble de processus moléculaires mesurables qui interagissent avec d’autres formes de régulation. Source: medlineplus.gov
Le milieu peut influencer les profils épigénétiques, mais les affirmations populaires dépassent souvent les recherches. Observer un changement après une exposition ne prouve pas qu’il provoque une maladie, dure toute la vie ou se transmet aux petits-enfants. Une grande partie de l’information épigénétique est réinitialisée lors de la reproduction. Démontrer une transmission entre générations exige de distinguer les explications génétiques, environnementales et développementales. La conclusion raisonnable est que la biologie répond aux circonstances, non que les pensées réécrivent librement le génome ou qu’un test épigénétique révèle toute une histoire personnelle. Source: genome.gov
Hérédité : pourquoi les membres d’une famille se ressemblent
L’hérédité commence avec la formation des ovules et des spermatozoïdes par méiose. Les paires chromosomiques se séparent et la recombinaison échange de l’ADN entre chromosomes correspondants. Les enfants héritent donc de combinaisons nouvelles, pas d’une moitié intacte des caractères visibles de chaque parent. Les différentes versions d’une séquence sont appelées allèles. Pour certaines maladies, une modification pathogène d’une seule copie du gène suffit ; pour d’autres, les deux doivent être affectées. Dominance et récessivité décrivent une relation entre variants et conséquences, pas la force ou la valeur d’un caractère. Source: medlineplus.gov
Dans une maladie autosomique récessive classique, deux porteurs non malades possédant chacun un variant pathogène du gène concerné ont, à chaque grossesse, une probabilité de 25 pour cent d’avoir un enfant atteint. Cette probabilité recommence à chaque grossesse : elle ne garantit pas un enfant atteint parmi quatre. D’autres affections suivent une transmission liée à l’X ou mitochondriale, et certaines résultent de nouveaux variants sans antécédents familiaux. La pénétrance et l’expressivité variable ajoutent de la complexité : des porteurs du même variant peuvent différer quant à l’apparition, l’âge de début ou la gravité de la maladie. Source: medlineplus.gov
Les mutations sont des changements, pas des jugements
Un variant génétique peut être une substitution d’une base, une petite insertion ou délétion, ou un réarrangement beaucoup plus vaste. Certains modifient une protéine, d’autres la régulation, et beaucoup ont peu d’effets détectables dans un contexte donné. Le mot mutation ne signifie pas qu’un événement monstrueux ou nécessairement nocif s’est produit. Les variants participent à la diversité biologique ordinaire tout en pouvant provoquer des maladies. Leurs conséquences dépendent de leur position, du changement moléculaire, d’autres facteurs génétiques et du milieu dans lequel vit l’organisme. Source: medlineplus.gov
Les variants germinaux peuvent être transmis par les ovules ou les spermatozoïdes. Les variants somatiques apparaissent dans d’autres cellules et peuvent créer, chez une même personne, des populations cellulaires génétiquement différentes : c’est le mosaïcisme. Le cancer implique souvent des changements acquis perturbant le contrôle de la croissance, même si des variants hérités peuvent accroître la susceptibilité. Une maladie peut donc être génétique sans être héréditaire. Trouver un changement d’ADN dans une tumeur ne signifie pas automatiquement que les proches le portent, et découvrir un variant de risque ne garantit pas une maladie. Source: medlineplus.gov
Maladies génétiques et limites de la prédiction
La drépanocytose montre comment une modification de l’hémoglobine peut transformer le comportement des globules rouges et provoquer une maladie grave. La mucoviscidose implique des variants pathogènes de CFTR, affectant une protéine du transport des sels. Les affections chromosomiques se situent à une autre échelle : la trisomie 21 comporte généralement une copie supplémentaire du chromosome 21. Ces exemples ne sont pas interchangeables. Un variant de séquence, un segment chromosomique manquant et un chromosome supplémentaire agissent par des mécanismes différents. Le diagnostic exige davantage que le constat d’une différence avec une référence. Source: medlineplus.gov
De nombreuses affections fréquentes, dont le diabète de type 2 et les maladies cardiaques, associent plusieurs influences génétiques à des facteurs environnementaux et sociaux. La taille et beaucoup de traits comportementaux sont également complexes. L’héritabilité décrit la variation dans une population étudiée dans certaines conditions, pas le pourcentage d’un individu déterminé par ses gènes. Une forte héritabilité ne prouve pas qu’un caractère est immuable. Les résultats génétiques ne justifient ni une hiérarchie figée de la valeur humaine ni l’idée d’un gène unique de l’intelligence, de l’ambition ou du sens moral. Source: medlineplus.gov
Un test impose aussi une question concrète : que changerait cette connaissance ? Un résultat peut éclaircir un diagnostic rare, guider une décision reproductive ou orienter un traitement. Il peut aussi laisser des incertitudes ou révéler un risque inattendu sans rapport avec la question initiale. Un résultat négatif n’exclut pas toutes les causes génétiques : les tests ne détectent pas tous les mêmes anomalies et les liens entre variants et maladies restent incomplets. L’interprétation associe résultats de laboratoire, données cliniques et histoire familiale. Le conseil génétique aide à comprendre ces limites plutôt qu’à lire un rapport comme un destin. Source: medlineplus.gov
D’un génome de référence à la diversité humaine
Le Projet génome humain, mené de 1990 à 2003, a établi une séquence de référence fondamentale. Son achèvement ne signifiait pas que toutes les régions étaient résolues : des séquences répétitives difficiles demeuraient. En 2022, le consortium Telomere-to-Telomere a présenté une séquence sans lacunes des autosomes et du chromosome X d’une lignée cellulaire particulière. Une séquence complète du chromosome Y a suivi en 2023. Ces progrès ont amélioré la carte, mais aucune séquence ne représente le génome de tout le monde. Une référence est un outil de comparaison, pas une norme de perfection biologique. Source: genome.gov Source: nature.com
Une première version du pangénome humain publiée en 2023 a intégré les génomes de 47 personnes pour mieux représenter les séquences alternatives et les variations structurales. La diversité compte aussi en médecine prédictive. Les scores de risque polygénique combinent de nombreux variants, mais leur performance dépend des populations et des données utilisées pour les établir. Ils peuvent mal se transférer à une population sous-représentée. Améliorer représentation, consentement et interprétation fait donc partie de l’exactitude scientifique. L’enjeu est de rendre la médecine génomique informative pour davantage de personnes. Source: nature.com Source: genome.gov
L’association mérite une autre distinction essentielle. Lorsqu’une région génomique apparaît plus souvent chez les personnes présentant un caractère, c’est le début d’une enquête, pas la preuve qu’une base particulière le provoque. Des variants voisins peuvent être transmis ensemble et le protocole d’étude peut introduire des signaux trompeurs. Les chercheurs associent statistiques, expériences moléculaires, réplication des résultats et observations cliniques pour identifier les mécanismes. Les découvertes les plus solides expliquent non seulement qu’une séquence diffère, mais comment cette différence agit sur la biologie. Beaucoup de résultats restent à des étapes intermédiaires. Source: genome.gov
L’ADN, archive de l’évolution
Les mutations créent de nouvelles variations ; la recombinaison réorganise celles qui existent. La sélection naturelle peut favoriser des variants améliorant le succès reproductif dans un milieu donné, tandis que la dérive génétique modifie les fréquences par hasard. Les migrations déplacent les variants entre populations. L’évolution n’est donc pas une marche vers la perfection, et les mutations n’apparaissent pas parce qu’un organisme sait ce dont il a besoin. Un variant utile dans un contexte peut être neutre ou défavorable ailleurs. Les comparaisons d’ADN révèlent les traces d’ancêtres communs et des changements ultérieurs. Source: medlineplus.gov
Ces principes moléculaires relient la génétique humaine au reste du vivant. Les bactéries copient et expriment aussi leur ADN, malgré des différences importantes d’organisation et de régulation. Leur évolution a fourni des outils aujourd’hui employés pour modifier les cellules humaines : les systèmes CRISPR proviennent de mécanismes de défense microbiens. Ces liens sont approfondis dans le dossier de PRESDA consacré aux bactéries. La biologie humaine devient plus compréhensible lorsqu’on la replace dans l’évolution, plutôt que d’en faire une invention séparée dont les règles moléculaires n’auraient aucun équivalent dans le vivant. PRESDA : bactéries Source: genome.gov
CRISPR : du laboratoire au traitement
L’édition fondée sur CRISPR utilise un ARN guide pour diriger une protéine associée vers une séquence cible. Dans une approche courante avec Cas9, la protéine coupe l’ADN et les mécanismes de réparation cellulaire contribuent à produire la modification. Cela ne rend pas l’édition automatiquement précise ou sûre : changements imprévus, édition incomplète, acheminement vers les bonnes cellules et réponses immunitaires doivent être étudiés. La thérapie génique dépasse CRISPR. Certains traitements ajoutent du matériel génétique sans modifier la séquence initiale ; d’autres transforment des cellules hors du corps avant de les réinjecter. Source: medlineplus.gov
En décembre 2023, la FDA américaine a autorisé Casgevy pour certains patients de 12 ans et plus atteints de drépanocytose : le premier traitement autorisé par cette agence utilisant CRISPR/Cas9. Il modifie les cellules souches hématopoïétiques du patient pour augmenter l’hémoglobine fœtale, plutôt que de réparer simplement le variant drépanocytaire dans toutes les cellules. Il exige prélèvement spécialisé, fabrication, chimiothérapie de conditionnement et transplantation, avec des risques importants et un suivi prolongé. C’est une avancée clinique majeure, pas un remède universel. La distinction entre possibilité expérimentale et traitement établi reste centrale dans l’histoire de la médecine. PRESDA : histoire de la médecine Source: fda.gov
Les applications de recherche comptent tout autant. Modifier une séquence dans des cellules cultivées aide à déterminer si elle change l’activité d’un gène ou la réponse à un médicament. Une expérience convaincante exige des comparaisons appropriées et une recherche des effets indésirables. Un résultat dans une boîte de culture ne devient pas automatiquement un traitement pour une personne entière, dont les tissus interagissent et dont le système immunitaire peut réagir autrement. Les modèles précisent les questions ; les études cliniques établissent le bénéfice réel. Cette progression est moins spectaculaire qu’un titre, mais construit la fiabilité.
L’avenir : intervenir avec humilité
L’édition de bases et le prime editing cherchent à introduire certains changements sans suivre la même stratégie de coupure des deux brins que Cas9 conventionnel. Une étude publiée dans Nature en 2019 a présenté le prime editing comme une méthode pour inscrire des modifications précises avec un guide et un système enzymatique modifié. Ces outils élargissent l’expérimentation sans supprimer l’évaluation de l’acheminement, des effets indésirables, de la durabilité et du bénéfice clinique. De même, séquencer un génome peut fournir un indice sans établir un diagnostic. Un variant de signification incertaine reste incertain jusqu’à l’obtention de preuves suffisantes. Source: nature.com Source: medlineplus.gov
Modifier des cellules non reproductrices pour soigner une personne diffère fondamentalement de changements héréditaires dans des embryons ou cellules reproductrices. Ces derniers pourraient toucher des générations incapables de consentir, avec des conséquences difficiles à prévoir ou inverser. Accès aux soins, droits des personnes handicapées, vie privée et frontière entre traitement et amélioration appartiennent au débat scientifique. Les données d’ADN concernent aussi les proches. L’avenir le plus crédible associe capacité technique, preuves rigoureuses et responsabilité publique. Le code contribue à nous construire ; le comprendre devrait approfondir le respect de notre complexité, pas réduire une vie à un verdict moléculaire. Source: genome.gov
La newsletter PRESDA
Suivez l’actualité. Gardez une longueur d’avance.
L’essentiel de l’IA, du jeu vidéo, du sport, de l’économie, de l’actualité internationale, des célébrités et de l’art de vivre.
Articles associés