DEL CEREBRO A LA VOZ: CÓMO LA IA DEVUELVE EL HABLA A QUIENES NO PUEDEN HABLAR
Los implantes cerebrales y la IA pueden convertir los intentos de hablar en palabras y sonido. La ciencia avanza desde frases con retraso hacia voces propias, gestos expresivos y comunicación diaria, pero sus límites importan.
Una conversación es más que una sucesión de palabras correctas. Es la posibilidad de responder antes de que cambie el tema, interrumpir con una pregunta, tranquilizar a alguien con una voz conocida o rematar un chiste en el momento preciso. Cuando una parálisis impide hablar, ese ritmo puede desaparecer aunque el deseo de comunicarse permanezca.
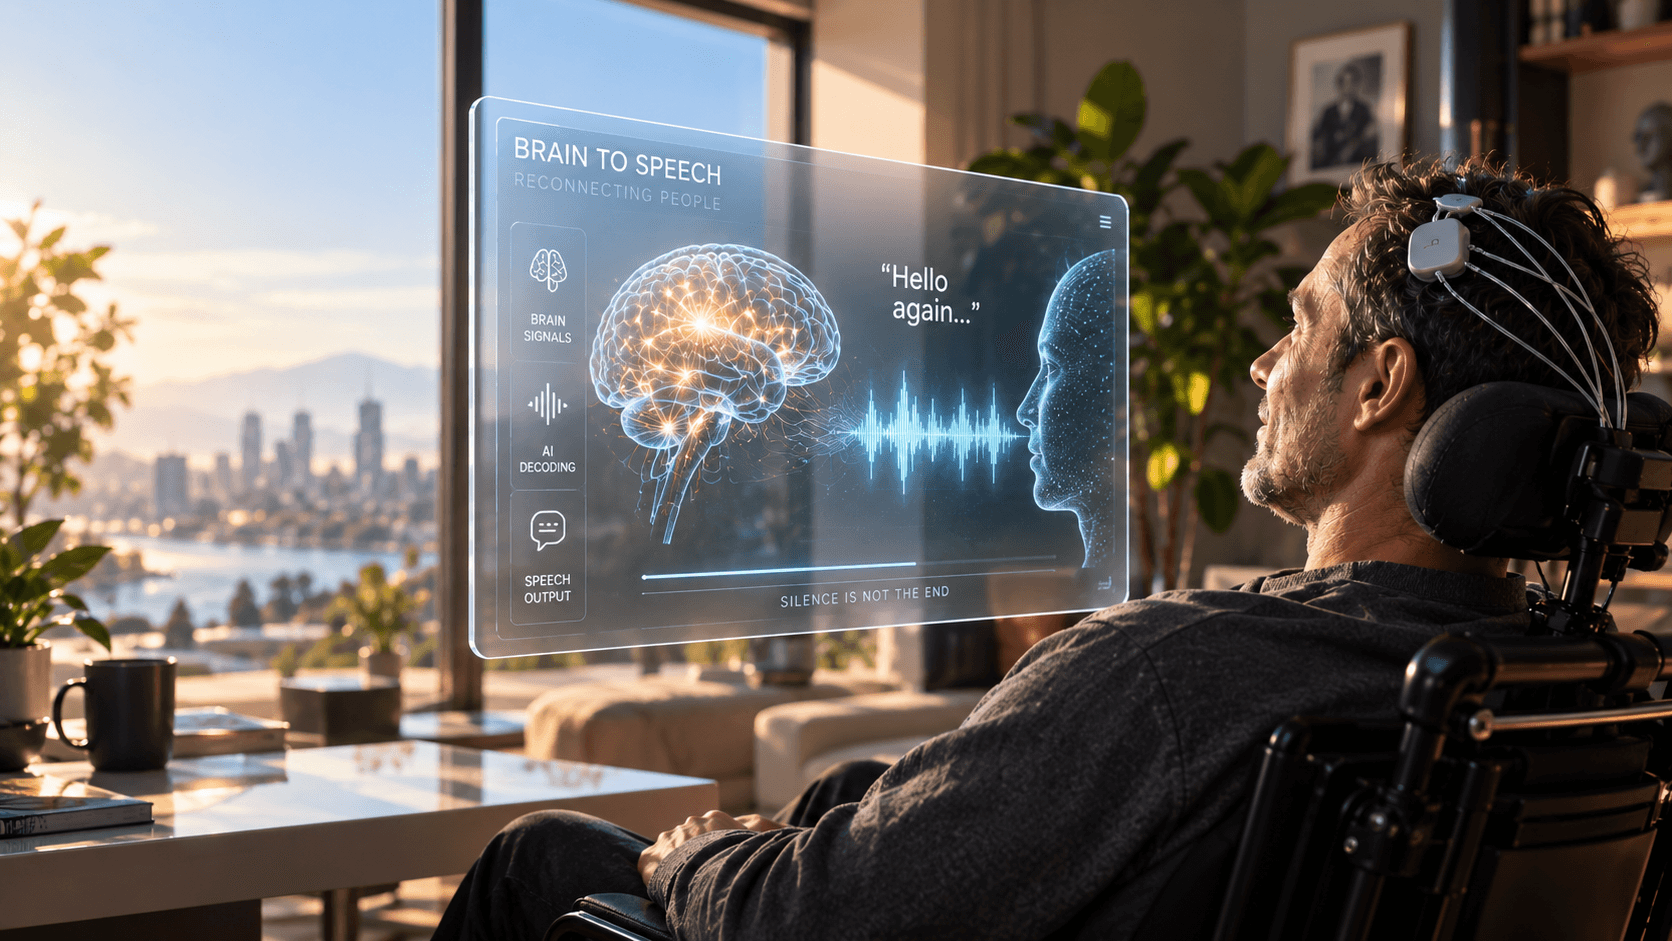
Las interfaces cerebro-ordenador del habla, o BCI del habla por sus siglas en inglés, crean una vía alternativa entre la actividad cerebral y la comunicación. Unos electrodos implantados registran señales asociadas al intento de hablar. Los modelos de inteligencia artificial entrenados convierten esas señales en texto o sonido sintético. No hace falta producir un habla inteligible para que el ordenador encuentre información útil.
Los principales estudios de conversión de actividad cerebral en voz publicados en 2025 acercaron esta vía a una conversación fluida. Las investigaciones publicadas en 2026 aportaron evidencia importante sobre el uso doméstico y la combinación del habla con gestos. Son sistemas experimentales probados en un número reducido de personas. No leen pensamientos libremente, no recuperan todas las experiencias mentales privadas ni curan la enfermedad que causó la pérdida del habla.
Evidencia comprobada hasta el 19 de septiembre de 2026. Este es un artículo de divulgación científica basado en investigaciones publicadas, no la presentación de un tratamiento disponible para todo el mundo. Imagen de cabecera: la ilustración proporcionada es conceptual, no una fotografía clínica ni una representación de los equipos utilizados en los estudios.
CÓMO SE CODIFICA EL HABLA EN EL CEREBRO
Hablar empieza antes de que se mueva la boca. Las redes cerebrales ayudan a seleccionar el significado, reunir las palabras, ordenar sus sonidos y preparar los movimientos que los producirán. Las regiones motoras coordinan los labios, la lengua, la mandíbula y la laringe, mientras los sistemas sensoriales ayudan a supervisar el resultado. Una palabra no se almacena como un archivo de audio perfectamente organizado que espera a que un electrodo lo descargue.
En un estudio de 2024 con cinco personas, los investigadores registraron neuronas individuales durante el habla y encontraron actividad relacionada con distintas unidades lingüísticas, incluidos sonidos del habla y partes de palabras. Esto ilustra por qué la descodificación requiere patrones entre neuronas y a lo largo del tiempo, en vez de un diccionario sencillo de una neurona por palabra. Los hallazgos se refieren, además, a una región registrada y una tarea concretas, no a un mapa completo del lenguaje. Explicación de los NIH sobre el estudio de 2024.
La oportunidad fundamental para una prótesis del habla es que parte de la maquinaria neuronal encargada de hablar puede seguir activa cuando el cuerpo no puede ejecutar sus órdenes. Así, el intento de pronunciar una palabra puede dejar un patrón medible aunque la persona no emita voz. La persistencia de señales útiles depende de la enfermedad o lesión y de las regiones cerebrales afectadas.
Para conocer la historia más amplia de esta extraordinaria capacidad humana, consulta Cómo aprendieron a hablar los seres humanos en PRESDA. La evolución del lenguaje y el reto de ingeniería de restituir su expresión están conectados, pero plantean preguntas diferentes.
QUÉ REGISTRA REALMENTE UN IMPLANTE
Un electrodo registra cambios eléctricos cerca de su contacto. No observa todo el cerebro ni identifica por sí solo el significado de una señal. La posición, la calidad del contacto, la estabilidad del registro y la tarea del participante determinan la información disponible para el descodificador.
Dos técnicas importantes son la electrocorticografía, llamada ECoG, y el registro intracortical. Una rejilla de ECoG descansa sobre la superficie cortical y recoge la actividad combinada de poblaciones neuronales cercanas en una zona. Los microelectrodos intracorticales penetran en el tejido cerebral y pueden registrar actividad mucho más localizada, incluidos los potenciales de acción neuronales. Ambas técnicas difieren fundamentalmente de un dispositivo de consumo que mide señales a través del cuero cabelludo. La rejilla superficial también requiere cirugía.
El sistema de registro amplifica y digitaliza pequeños cambios de voltaje, elimina o reduce interferencias y extrae características que puede utilizar un modelo de IA. Estas pueden describir la intensidad de determinadas bandas de frecuencia o la frecuencia con la que se activan las neuronas cercanas. Un ordenador externo puede procesarlas después. Registrar la actividad cerebral y estimular el cerebro son funciones distintas; los sistemas del habla descritos aquí utilizan principalmente el registro para crear una vía de expresión. Revisión científica de las neuroprótesis del habla.
CÓMO CONVIERTE LA IA UN INTENTO DE HABLAR EN TEXTO Y SONIDO
El entrenamiento comienza con ejemplos. El participante ve una frase e intenta pronunciarla mientras el sistema registra la actividad neuronal. El texto conocido proporciona un objetivo y ayuda al modelo a aprender qué patrones cambiantes acompañan al habla que se intenta producir. Después, los investigadores deben probarlo con ejemplos reservados para la evaluación, para establecer si aprendió algo más que el material de entrenamiento.
Un descodificador de texto puede estimar secuencias de sonidos del habla o unidades textuales más pequeñas y combinarlas en palabras. Un modelo de lenguaje ayuda a resolver ambigüedades asignando probabilidades a secuencias plausibles. Esto puede mejorar la comunicación, pero que algo sea plausible no demuestra que fuera la intención del hablante. Una frase fluida puede contener una palabra incorrecta, especialmente si se trata de un nombre o una expresión poco habitual.
Una vez que existe texto, un sistema convencional de síntesis de voz puede leerlo en voz alta. La síntesis directa de voz a partir del cerebro sigue otra vía: el descodificador predice características acústicas o unidades del habla y un sintetizador convierte esas predicciones en sonido. Esto puede conservar aspectos del ritmo y la expresividad que una transcripción textual no especifica por completo.
El sistema de UC Davis de 2025 ilustra la vía acústica. Su descodificador neuronal proporcionaba información sobre la calidad del sonido, el tono y la sonoridad a un vocoder, el componente que genera la forma de onda del audio. Como no había una grabación clara de habla natural que sirviera de objetivo, los investigadores alinearon habla sintética de entrenamiento con la actividad neuronal del participante. Nature: métodos y proceso del estudio.
Esta es una distinción útil respecto a un chatbot generalista. La ayuda a la comunicación debe expresar el mensaje que el usuario desea transmitir, no inventar una respuesta en su nombre. La guía de PRESDA sobre por qué confiamos en la IA como en un amigo explora por qué una respuesta segura y de apariencia humana puede inspirar más confianza de la que justifica su precisión.
LOS ESTUDIOS CLAVE DE 2025 SOBRE CONVERSIÓN DEL CEREBRO EN VOZ
Habla continua tras un ictus del tronco encefálico
Littlejohn y colaboradores publicaron su estudio en Nature Neuroscience el 31 de marzo de 2025. La demostración en directo de conversión de actividad cerebral en voz se realizó con una mujer que tenía parálisis grave y había perdido el habla articulada tras un ictus. Los registros de la superficie cortical alimentaban un sistema que emitía el habla progresivamente, sin esperar a que terminara la frase completa. El modelo procesaba la entrada neuronal en intervalos de 80 milisegundos. Estudio original.
Según los NIH, el entrenamiento incluyó más de 23.000 intentos de habla silenciosa correspondientes a más de 12.000 frases. La velocidad de síntesis comunicada fue de 47,5 palabras por minuto en la condición con vocabulario más amplio. Fue un avance significativo, pero detrás de la demostración hubo un esfuerzo considerable de la participante. No era un dispositivo que entendiera inmediatamente a un usuario nuevo. Resumen del estudio de los NIH.
Síntesis de voz directa y expresiva en la ELA
Wairagkar y colaboradores publicaron otro estudio en Nature el 12 de junio de 2025 con un hombre que tenía ELA y disartria grave, es decir, dificultad para producir un habla clara. Los registros procedían de 256 microelectrodos. El participante podía influir en características de la voz sintetizada, incluida la entonación, y demostró una producción melódica sencilla. Estudio original.
UC Davis comunica un retraso del audio de unos 25 milisegundos y una comprensión por parte de los oyentes de casi el 60 % de las palabras sintetizadas, frente a aproximadamente el 4 % del habla del participante sin ayuda. El sistema también demostró palabras no familiares e interjecciones. La mejora fue considerable, pero los malentendidos restantes también lo fueron. Se trataba de un participante, no del resultado medio de las personas con ELA. Descripción de la investigación de UC Davis.
RENDIMIENTO REAL: VELOCIDAD, LATENCIA, PRECISIÓN Y VOCABULARIO
La comparación siguiente separa la descodificación de texto de la síntesis directa de voz. El número de participantes se refiere a las personas que aportaron la demostración clínica, no al número de frases, electrodos o valoraciones de oyentes. Estos estudios utilizaron tareas diferentes y no deben interpretarse como una clasificación comparativa directa de dispositivos.
| Estudio y muestra | Salida y vocabulario | Rendimiento medido | Interpretación |
|---|---|---|---|
| Card y colaboradores, 2024, NEJM; n = 1, ELA | Descodificación de texto; vocabulario de 125.000 palabras | Unas 32 palabras/min en conversación; 97,5 % de precisión por palabra tras entrenamiento adicional | Precisión textual, no inteligibilidad de voz sintetizada directamente |
| Littlejohn y colaboradores, 2025, Nature Neuroscience; n = 1, ictus | Voz continua; conjunto general de 1.024 palabras | 47,5 palabras sintetizadas/min; intervalos de procesamiento de 80 ms | El intervalo de procesamiento no es el tiempo hasta la primera palabra audible; la transcripción de oyentes evaluó la inteligibilidad |
| Wairagkar y colaboradores, 2025, Nature; n = 1, ELA | Voz directa; también se demostraron palabras no familiares | Unos 25 ms de retraso del audio; los oyentes entendieron casi el 60 % de las palabras | No se cita aquí una medida única comparable en palabras/min; las demostraciones con palabras no familiares no establecen una precisión ilimitada |
| Card y colaboradores, 2026, Nature Medicine; n = 1, ELA | Texto y control del cursor; vocabulario de 125.000 palabras | 56 palabras/min de media; más del 99 % de precisión por palabra en pruebas con frases indicadas | El usuario calificó el 92 % de las frases cotidianas como al menos mayoritariamente correctas; es distinto de la precisión por palabra |
Fuentes de la tabla: Card y colaboradores, 2024, Littlejohn y colaboradores, 2025, UC Davis sobre Wairagkar y colaboradores, 2025, Card y colaboradores, 2026.
La latencia necesita un punto de inicio y otro de finalización. Un intervalo de procesamiento describe con qué frecuencia se actualiza un modelo. El retraso del sistema de audio mide cuánto tarda la cadena de procesamiento. El tiempo desde una señal de inicio hasta la primera salida incluye, además, la respuesta del participante y el comienzo del habla. En el estudio de voz continua de 2025, la mediana del tiempo entre la señal y el inicio del habla sintetizada fue de 1,67 segundos en la condición de vocabulario general. Sería incorrecto llamar a toda esa espera 80 milisegundos. Figura 3 de datos ampliados.
Las palabras por minuto también necesitan contexto. El estudio de voz continua comparó un conjunto general de 1.024 palabras con un conjunto limitado de 50 frases de comunicación asistida. Una tarea con frases restringidas puede resultar más fácil y rápida que construir una conversación sin restricciones. El tamaño del vocabulario de un descodificador describe su repertorio de palabras disponible, no el número de palabras cuya precisión se ha demostrado por igual en el uso cotidiano. Definiciones de las tareas y evaluación.
La precisión puede significar cosas distintas. La tasa de error de palabras cuenta sustituciones, omisiones y palabras añadidas respecto a una transcripción de referencia. La transcripción realizada por oyentes comprueba si las personas entienden el audio generado. Elegir la frase correcta de una lista breve es más fácil que escribir un habla desconocida sin opciones. El estudio de voz de Nature de 2025 incluyó ambos tipos de pruebas de escucha; por eso sus excelentes resultados al seleccionar frases no deben presentarse como un habla abierta perfecta. Nature: evaluación de la comprensión auditiva.
El sistema de texto de 2024 ofrece un contraste útil: los NIH comunicaron aproximadamente un 97,5 % de precisión por palabra tras entrenamiento adicional y un uso conversacional de unas 32 palabras por minuto en un participante. Esas cifras describen una vía de descodificación y una evaluación distintas de las del experimento de voz directa de 2025. Atribuir esa precisión a la demostración de voz más reciente crearía un resultado que ningún estudio comunicó realmente. NIH sobre el estudio de 2024.
CÓMO PUEDE VOLVER UNA VOZ CONOCIDA
La voz de una persona transmite identidad, además de información. Reconstruir una versión sintética reconocible exige separar lo que la persona intenta decir de cómo debe sonar la voz resultante. El descodificador neuronal aporta la señal de comunicación; un modelo de voz personalizado aporta características aprendidas de grabaciones.
En el estudio de voz continua de 2025, una grabación antigua ayudó a personalizar la salida para que se pareciera a la voz de la participante antes de la lesión. El estudio de síntesis de voz de Nature también demostró un modelo personalizado mediante grabaciones anteriores a la ELA. Ninguna de las dos técnicas extrajo una voz anterior intacta de una grabación oculta en el cerebro. Estudio de voz continua, Nature: demostración de voz personalizada.
La personalización es una reconstrucción. El parecido depende de las grabaciones disponibles y del modelo. Un timbre familiar no demuestra que se hayan recuperado todos los detalles del acento, las emociones o los hábitos de conversación. Tampoco demuestra que las palabras descodificadas sean correctas. Los pacientes deberían poder elegir si desean una voz recreada, otra voz o solo texto, y controlar la reutilización de sus grabaciones.
INTENTAR HABLAR NO ES LO MISMO QUE EL HABLA INTERNA PRIVADA
El habla intentada significa tratar de ejecutar el acto de hablar, incluso cuando la parálisis impide el movimiento o el sonido esperados. El habla interna son las palabras experimentadas mentalmente sin intentar articularlas. Ambas pueden ser silenciosas para quien observa. Por eso la expresión habla silenciosa es demasiado ambigua para explicar qué pidió realmente un experimento al participante.
La distinción es real, pero las señales no están completamente separadas. El estudio de Kunz y colaboradores publicado en Cell en 2025 registró a cuatro participantes con alteraciones del habla causadas por ELA o ictus. Encontró representaciones relacionadas del habla intentada y del habla interna en la corteza motora, con diferencias que podrían ayudar a distinguirlas. El equipo demostró la descodificación deliberada del habla interna y también recuperó aspectos del contenido verbal durante tareas estructuradas de contar y recordar secuencias. Estudio de Cell, manuscrito abierto.
Esto no demuestra un acceso ilimitado a la vida privada de una persona. La investigación utilizó sensores implantados, modelos específicos para cada participante y tareas controladas. Sí demuestra por qué la privacidad no puede basarse en la promesa de que la corteza motora solo contiene órdenes deliberadas. El habla interna es, a su vez, solo una parte del pensamiento; los recuerdos, sentimientos e intenciones abstractas no equivalen a una frase imaginada con palabras.
Los NIH comunican tasas de error de palabras del 14 % al 33 % en la condición de habla interna de 50 palabras y del 26 % al 54 % con un vocabulario de 125.000 palabras. Estos resultados dependían de la condición y del participante, no eran una precisión universal de lectura del pensamiento. La cohorte total del estudio era de cuatro personas; no todas participaron en cada experimento de descodificación. Explicación de los NIH.
SEPTIEMBRE DE 2026: HABLA Y GESTOS CON UN SOLO IMPLANTE
El artículo de Brosler y colaboradores en Nature Neuroscience, publicado el 14 de septiembre de 2026, estudió a tres participantes en total. Los experimentos de habla y gestos simultáneos incluyeron a dos. Una única rejilla de ECoG por participante registraba regiones que intervienen en varios movimientos, permitiendo que descodificadores paralelos controlaran la salida de habla y un avatar de cuerpo completo. Artículo original de 2026.
Los repertorios comunicativos eran deliberadamente pequeños: un participante utilizó cinco enunciados y cuatro gestos, mientras que el otro utilizó diez enunciados y diez gestos. Eran opciones discretas, no una lengua de signos sin restricciones ni movimientos corporales arbitrarios. El entrenamiento con conductas simultáneas mejoró el rendimiento cuando ambas ocurrían a la vez; el entrenamiento entre modalidades también redujo las activaciones no deseadas.
El logro es una prueba de concepto de una expresión más rica: un avatar puede acompañar una frase con un gesto comunicativo. No significa que el implante restituyera el movimiento físico, descodificara cualquier gesto a demanda o combinara una conversación sin restricciones con un cuerpo virtual completo. El siguiente reto es conseguir que esas salidas sean fiables para una variedad mucho mayor de expresiones sin confundir una intención con otra.
¿QUIÉN PODRÍA BENEFICIARSE Y QUIÉN PODRÍA NO HACERLO?
La evidencia directa más sólida que se aborda aquí corresponde a personas con ELA o ictus del tronco encefálico cuya producción del habla está gravemente afectada. La ELA puede dañar las vías motoras necesarias para hablar. Un ictus del tronco encefálico puede interrumpir la comunicación entre una corteza que por lo demás funciona y los músculos. Un descodificador puede sortear parte de esa vía de salida dañada.
Otras causas de parálisis grave o de alteración motora del habla podrían ser candidatas para estudios futuros, siempre que queden señales útiles relacionadas con el habla. Es una posibilidad de investigación, no una garantía. Una persona que no puede hablar porque está dañada la propia formulación del lenguaje plantea un problema distinto de quien puede formular una frase, pero no articularla.
En particular, no puede suponerse que la afasia tras un ictus cortical responda igual que la parálisis tras un ictus del tronco encefálico. Las alteraciones cognitivas graves, el daño en las regiones objetivo, los riesgos para la salud o la imposibilidad de completar el entrenamiento pueden modificar la idoneidad. El artículo de PRESDA sobre el alzhéimer y la pérdida de memoria aporta contexto sobre por qué las distintas afecciones cerebrales no deben tratarse como un único problema de ingeniería.
Los métodos de comunicación existentes siguen siendo relevantes: el seguimiento ocular, los pulsadores, los tableros de comunicación y los dispositivos generadores de voz pueden ofrecer medios importantes para comunicarse sin cirugía cerebral. La pregunta práctica es qué técnica proporciona a cada persona el control más fiable con una carga aceptable. Un implante tecnológicamente impresionante no es automáticamente la mejor elección para todos los usuarios.
CIRUGÍA, ENTRENAMIENTO Y VIDA COTIDIANA
La implantación requiere neurocirugía y una evaluación individualizada de riesgos como infección, hemorragia y daño tisular. Los componentes que atraviesan la piel requieren cuidados; los elementos implantados y sus conexiones deben seguir siendo fiables. Una sesión de registro exitosa no demuestra seguridad de por vida. Revisión del campo.
El entrenamiento es otra carga. Los participantes pueden repetir frases indicadas mientras los investigadores ajustan modelos y tiempos y revisan los errores. La fatiga importa, especialmente cuando intentar hablar exige esfuerzo. Los cambios en las señales neuronales también pueden requerir recalibración. El objetivo es un sistema al servicio de la vida diaria de alguien, no una vida organizada en torno al mantenimiento del sistema.
Un informe de Nature Medicine del 15 de junio de 2026 avanzó hacia ese objetivo en un hombre con ELA. Documentó más de 3.800 horas de uso doméstico de una BCI, con ayuda de las personas cuidadoras para la preparación y sin necesidad de que hubiera investigadores presentes durante el uso autónomo. La velocidad media de comunicación fue de 56 palabras por minuto. Las pruebas formales con frases indicadas superaron el 99 % de precisión por palabra con un vocabulario de 125.000 palabras; el participante calificó el 92 % de las frases cotidianas como, al menos, mayoritariamente correctas. Son medidas distintas, y el uso registrado incluye actividades diferentes de hablar. Estudio de uso doméstico de 2026.
Esto aporta evidencia considerable de que puede existir una vida útil más allá de una demostración supervisada. Sigue siendo un resultado experimental de un solo participante. No debe convertirse en la promesa de la misma precisión, autonomía o experiencia de preparación para todo el mundo.
¿PUEDE UNA BCI LEER PENSAMIENTOS SIN PERMISO?
Las BCI del habla actuales no pueden inspeccionar libremente los pensamientos de un desconocido. Dependen del acceso a señales cerebrales y de una descodificación especializada. Sin embargo, la intención de un usuario con implante de mantener algo en privado no constituye automáticamente una barrera física frente a un descodificador. Los hallazgos de 2025 sobre habla interna concretan ese riesgo más limitado.
Los investigadores demostraron técnicas que suprimen la salida de habla interna en un descodificador de habla intentada, y un mecanismo de activación deliberada mediante palabra clave para una interfaz de habla interna. Los NIH comunican un reconocimiento de la palabra clave superior al 98 % en el contexto probado. Es evidencia prometedora para el control del usuario, no una garantía frente a toda activación accidental o modificación maliciosa del software. NIH sobre las estrategias de privacidad.
Conviene distinguir entre recoger una señal, inferir palabras a partir de ella y emitirlas. Silenciar un altavoz solo aborda el último paso. Un diseño respetuoso con la privacidad debería indicar claramente cuándo está activo, ofrecer un control accesible para detenerlo y explicar qué registros neuronales y transcripciones se guardan, dónde se procesan y quién puede acceder a los datos.
Son requisitos de diseño y prioridades éticas, no características cuya presencia se haya demostrado en todas las BCI experimentales. Los usuarios deberían controlar si sus datos pueden entrenar sistemas posteriores, si su voz sintética puede reutilizarse y qué ocurre al abandonar un ensayo. El consentimiento debe seguir teniendo sentido después de la implantación. Para ampliar el contexto del papel social de la IA asistencial, lee Japón entra en la era de los cuidados con IA.
¿QUÉ DEBE MEJORAR ANTES DE UN USO CLÍNICO GENERALIZADO?
La replicación es lo primero. Los estudios necesitan más participantes con distintas afecciones, acentos, lenguas y grados de afectación. Los investigadores deben establecer quién se beneficia, quién no y con qué frecuencia se producen complicaciones o fallos. Un resultado impresionante en una persona puede justificar nuevos ensayos sin resolver esas preguntas.
La fiabilidad debe abarcar la vida cotidiana: fatiga, interrupciones, nombres desconocidos, conversaciones de fondo, cambios de postura y días de mala calidad de las señales. La evaluación debería contabilizar la salida no deseada y el tiempo dedicado a corregir errores, además de la velocidad máxima de descodificación. Una forma fiable de indicar que un mensaje era incorrecto es parte de la comunicación, no un añadido opcional.
Debe ser más fácil convivir con los equipos. La estabilidad de las señales a largo plazo, una preparación manejable, conexiones resistentes y software que pueda mantenerse importan tanto como el resultado de una prueba algorítmica. Los sistemas más pequeños o inalámbricos son líneas de desarrollo importantes, pero hacer inalámbrico un dispositivo no demuestra por sí solo un rendimiento equivalente ni elimina los riesgos quirúrgicos.
La atención clínica también necesita equipos formados, apoyo rehabilitador, mecanismos de reparación y un plan creíble para mantener el acceso cuando termine un ensayo o desaparezca una empresa. Los costes y la cobertura deben evaluarse junto con los beneficios. Un sistema de comunicación no debería volverse inutilizable porque el equipo de investigación original ya no esté disponible.
HACIA DÓNDE PODRÍA AVANZAR LA TECNOLOGÍA DEL CEREBRO A LA VOZ
Los avances demostrados incluyen voz continua, modulación deliberada de la expresión vocal, voces sintéticas personalizadas, comunicación restringida que combina habla y gestos y uso autónomo prolongado en el hogar por participantes individuales. Estos logros corresponden a sistemas y tareas distintos. Ningún estudio demuestra todas las capacidades a la vez.
Entre las posibilidades futuras están turnos de conversación más naturales, una expresión más rica, repertorios gestuales mayores, un mejor soporte multilingüe y el paso fluido del texto privado a la conversación audible. Deben considerarse objetivos de desarrollo. Su valor dependerá de si conservan el significado que desea transmitir el hablante y reducen el esfuerzo cotidiano.
Una prueba útil para la siguiente generación es fácil de formular, aunque difícil de resolver técnicamente: ¿puede una persona iniciar, pausar, corregir y terminar una conversación cuando quiera? ¿Puede sonar como ella misma sin renunciar al control de sus palabras o grabaciones? ¿Puede el dispositivo seguir siendo útil en un día difícil corriente, y no solo durante una demostración cuidadosamente preparada?
La promesa de la tecnología del cerebro a la voz reside en esa capacidad de decisión. Escuchar una voz conocida puede emocionar, pero el logro más profundo es permitir que alguien decida qué decir, cuándo decirlo y cuándo guardar silencio.
FUENTES Y NOTAS SOBRE LA EVIDENCIA
Los artículos originales y las explicaciones institucionales siguientes respaldan las afirmaciones específicas de cada estudio. Los años corresponden a la publicación; el número de participantes se indica junto a cada estudio. Este artículo distingue entre resultados en directo, tareas experimentales y posibilidades futuras. Algunos artículos de Nature solo ofrecen sin suscripción el resumen, figuras públicas o material complementario; los resúmenes de los NIH y el manuscrito abierto de Cell aportan contexto accesible adicional.
Wairagkar y colaboradores, Nature (2025): síntesis instantánea de voz, un participante.
NIH (2025): una interfaz cerebro-ordenador restituye el habla natural tras una parálisis.
UC Davis (2025): habla en tiempo real, latencia e inteligibilidad para los oyentes.
NIH (2025): descodificación del habla interna a partir de señales cerebrales.
NIH (2024): cómo produce el cerebro el habla, cinco participantes.
NIH (2024): una interfaz cerebro-ordenador ayuda a hablar a un hombre con parálisis.
Silva y colaboradores, Nature Reviews Neuroscience (2024): revisión sobre la neuroprótesis del habla.
FAQ
Preguntas frecuentes
¿Puede un implante cerebral devolver el habla a todas las personas que no pueden hablar?
No. Los resultados citados proceden de participantes seleccionados para investigaciones. La idoneidad depende de la causa de la pérdida del habla, de que existan señales neuronales útiles, de poder someterse a cirugía y de la capacidad para entrenar y utilizar el sistema. Estos dispositivos siguen siendo experimentales.
¿Una voz reconstruida mediante IA equivale a recuperar el habla natural?
No. Es audio sintético producido mediante un ordenador, a veces personalizado con grabaciones anteriores. No restituye los músculos o nervios dañados, y una voz familiar puede seguir conteniendo errores de descodificación.
¿Descodificar los intentos de hablar revela todos los pensamientos privados?
No. El habla intentada y el habla interna privada son diferentes, aunque sus patrones neuronales pueden solaparse. Los experimentos controlados de habla interna muestran un riesgo limitado para la privacidad que exige salvaguardas deliberadas, no una lectura ilimitada del pensamiento.
El boletín de PRESDA
Sigue la actualidad. Entiende lo que pasa.
Las claves de la IA, los videojuegos, el deporte, la economía, la actualidad internacional, los famosos y el estilo de vida.