DU CERVEAU À LA VOIX : COMMENT L’IA REDONNE LA PAROLE
Les implants cérébraux et l’IA transforment des tentatives de parole en mots et en sons. La recherche passe des phrases différées aux voix personnelles, aux gestes expressifs et à la communication quotidienne, avec des limites essentielles.
Une conversation est plus qu’une suite de mots corrects. C’est pouvoir répondre avant que le sujet change, interrompre par une question, rassurer avec une voix familière ou terminer une plaisanterie au bon moment. Lorsque la paralysie prive de parole, ce rythme peut disparaître alors que l’envie de communiquer reste intacte.
Les interfaces cerveau-ordinateur dédiées à la parole, ou BCI de parole, créent une autre voie entre l’activité cérébrale et la communication. Des électrodes implantées enregistrent des signaux associés à la tentative de parler. Des modèles d’IA entraînés les traduisent en texte ou en son synthétique. La personne n’a pas besoin de produire une parole intelligible pour que l’ordinateur trouve des informations utiles.
Les grandes études de 2025 sur la conversion de l’activité cérébrale en voix ont rapproché cette voie d’une conversation fluide. Les recherches de 2026 ont apporté des données importantes sur l’usage à domicile et l’association de la parole aux gestes. Ce sont des systèmes expérimentaux testés chez peu de personnes. Ils ne lisent pas librement les pensées, ne récupèrent pas chaque expérience mentale privée et ne guérissent pas la maladie responsable de la perte de parole.
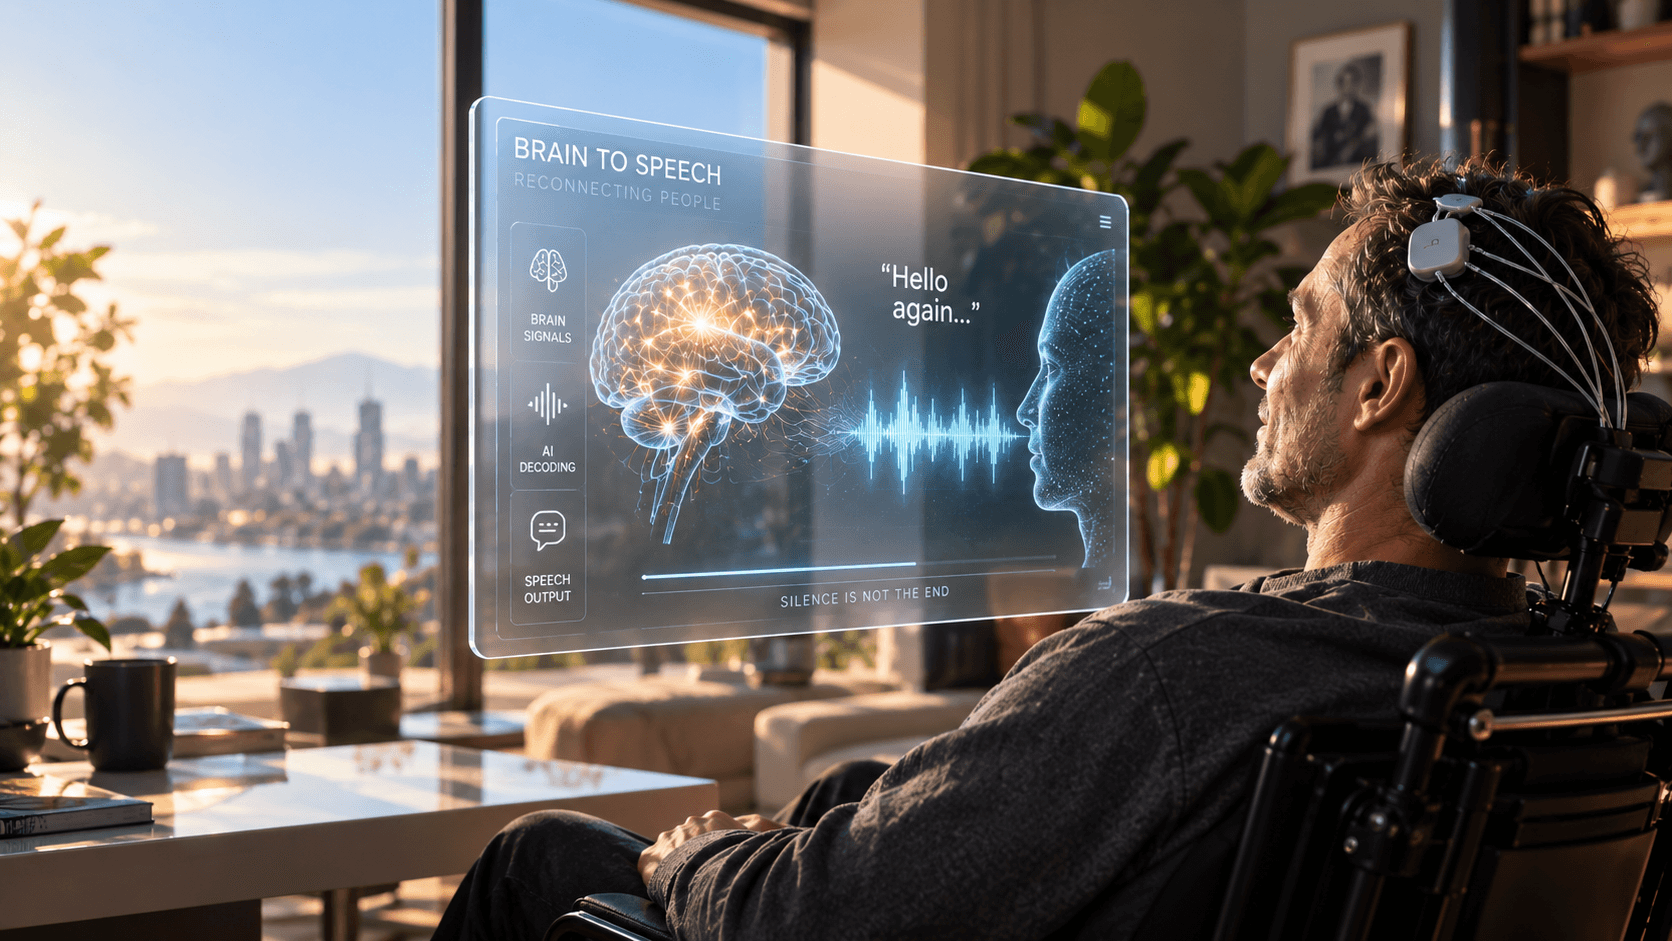
Données vérifiées jusqu’au 19 septembre 2026. Cet article explique des recherches publiées, pas un traitement accessible à tous. L’image principale est une illustration conceptuelle, pas une photographie clinique ni une représentation du matériel utilisé dans les études.
COMMENT LE CERVEAU CODE LA PAROLE
Parler commence avant que la bouche bouge. Des réseaux cérébraux sélectionnent le sens, assemblent les mots, organisent leurs sons et préparent les mouvements nécessaires. Les régions motrices coordonnent lèvres, langue, mâchoire et larynx, tandis que les systèmes sensoriels surveillent le résultat. Un mot n’est pas stocké comme un fichier audio bien rangé qu’une électrode pourrait télécharger.
Dans une étude de 2024 menée chez cinq personnes, des chercheurs ont enregistré des neurones individuels pendant la parole et observé une activité liée à différentes unités linguistiques, notamment des sons et des parties de mots. Cela montre pourquoi le décodage nécessite des motifs répartis entre neurones et dans le temps, plutôt qu’un simple dictionnaire d’un neurone par mot. Les résultats concernent aussi une région enregistrée et une tâche précises, pas une carte complète du langage. NIH : présentation de l’étude de 2024.
La possibilité essentielle pour une prothèse de parole est qu’une partie des mécanismes neuronaux du langage oral peut rester active lorsque le corps n’exécute plus ses commandes. Une tentative de mot peut ainsi laisser une trace mesurable même sans voix. La présence de signaux utiles dépend de la maladie et des régions cérébrales atteintes.
Pour découvrir l’histoire plus large de cette capacité humaine remarquable, lisez Comment les humains ont appris à parler. L’évolution du langage et le problème technique de restituer son expression sont liés, mais posent des questions différentes.
CE QU’ENREGISTRE RÉELLEMENT UN IMPLANT
Une électrode enregistre des variations électriques près de son contact. Elle n’observe pas tout le cerveau et n’identifie pas seule le sens d’un signal. Sa position, la qualité du contact, la stabilité de l’enregistrement et la tâche du participant déterminent les informations disponibles pour le décodeur.
Deux approches importantes sont l’électrocorticographie, ou ECoG, et l’enregistrement intracortical. Une grille ECoG repose à la surface du cortex et mesure l’activité combinée de populations neuronales voisines sur une zone. Les microélectrodes intracorticales pénètrent dans le tissu cérébral et enregistrent une activité bien plus locale, notamment des décharges neuronales. Ces deux approches diffèrent fondamentalement d’un casque grand public mesurant à travers le cuir chevelu. Même la grille de surface nécessite une opération.
Le système amplifie et numérise de faibles variations de tension, supprime ou réduit les interférences et extrait des caractéristiques exploitables par l’IA. Elles peuvent décrire l’intensité de certaines bandes de fréquences ou la fréquence de décharge de neurones voisins. Un ordinateur externe traite ensuite ces informations. Enregistrer l’activité cérébrale et stimuler le cerveau sont deux fonctions différentes ; les systèmes décrits ici utilisent surtout l’enregistrement pour créer une voie d’expression. Revue scientifique des neuroprothèses de parole.
COMMENT L’IA TRANSFORME UNE TENTATIVE EN TEXTE ET EN SON
L’entraînement commence par des exemples. Le participant voit une phrase et tente de la prononcer pendant l’enregistrement neuronal. La consigne connue fournit une cible : le modèle apprend quels motifs changeants accompagnent la parole voulue. Les chercheurs doivent ensuite le tester sur des exemples réservés à l’évaluation pour vérifier qu’il a appris davantage que le matériel d’entraînement.
Un décodeur textuel peut estimer des séquences de sons ou de petites unités textuelles et les combiner en mots. Un modèle de langage aide à résoudre les ambiguïtés en attribuant des probabilités aux séquences plausibles. Cela peut améliorer la communication, mais la plausibilité ne prouve pas l’intention. Une phrase fluide peut contenir le mauvais mot, notamment un nom propre ou une expression inhabituelle.
Une fois le texte disponible, un système classique de synthèse vocale peut le lire. La synthèse directe du cerveau vers la voix suit une autre voie : le décodeur prédit des caractéristiques acoustiques ou des unités de parole, puis un synthétiseur les transforme en son. Cela peut préserver des aspects de rythme et d’expression qu’une transcription seule ne décrit pas entièrement.
Le système de l’UC Davis de 2025 illustre la voie acoustique. Son décodeur neuronal transmettait des informations sur la qualité sonore, la hauteur et le voisement à un vocodeur, composant qui génère l’onde audio. Faute d’enregistrement clair de parole naturelle pouvant servir de cible, les chercheurs ont aligné une parole synthétique d’entraînement sur l’activité neuronale du participant. Nature : méthodes et chaîne de traitement de l’étude.
La distinction avec un chatbot généraliste est importante. L’aide à la communication doit exprimer le message voulu par l’utilisateur, pas inventer une réponse à sa place. Notre article sur la confiance accordée à l’IA comme à un ami explique pourquoi une expression assurée et humaine peut inspirer plus de confiance que sa précision ne le justifie.
LES GRANDES ÉTUDES DE 2025 SUR LA VOIX ISSUE DU CERVEAU
Une parole en continu après un AVC du tronc cérébral
Littlejohn et ses collègues ont publié leur étude dans Nature Neuroscience le 31 mars 2025. La démonstration en direct concernait une femme atteinte de paralysie sévère et privée de parole articulée après un AVC. Des enregistrements à la surface du cortex pilotaient un système émettant progressivement la parole au lieu d’attendre la fin d’une phrase entière. Le modèle traitait les données neuronales par intervalles de 80 millisecondes. Étude originale.
Selon les NIH, l’entraînement a comporté plus de 23 000 tentatives de parole silencieuse portant sur plus de 12 000 phrases. Le débit synthétisé rapporté était de 47,5 mots par minute dans la condition au vocabulaire le plus large. C’était un progrès réel, mais un effort considérable de la participante précédait la démonstration. L’appareil ne comprenait pas immédiatement un nouvel utilisateur. NIH : résumé de l’étude.
Une voix directe et expressive dans la SLA
Wairagkar et ses collègues ont publié une autre étude dans Nature le 12 juin 2025, chez un homme atteint de sclérose latérale amyotrophique, ou SLA, et de dysarthrie sévère, c’est-à-dire de difficultés à produire une parole claire. Les enregistrements provenaient de 256 microélectrodes. Le participant pouvait modifier des caractéristiques de la voix synthétisée, notamment l’intonation, et a produit une mélodie simple. Étude originale.
L’UC Davis rapporte un délai audio d’environ 25 millisecondes et une compréhension par les auditeurs de près de 60 % des mots synthétisés, contre environ 4 % de la parole sans assistance du participant. Le système a aussi démontré des mots nouveaux pour lui et des interjections. Le gain était important, mais les incompréhensions restantes l’étaient aussi. Il s’agissait d’un participant, pas d’un résultat moyen pour les personnes atteintes de SLA. UC Davis : présentation des recherches.
LES PERFORMANCES RÉELLES : DÉBIT, LATENCE, PRÉCISION ET VOCABULAIRE
La comparaison suivante sépare le décodage textuel de la synthèse vocale directe. Le nombre de participants désigne les personnes ayant contribué à la démonstration clinique, pas le nombre de phrases, d’électrodes ou d’évaluations d’auditeurs. Les tâches différaient ; ce tableau n’est pas un classement comparatif direct des dispositifs.
| Étude et échantillon | Sortie et vocabulaire | Performances mesurées | Interprétation |
|---|---|---|---|
| Card et ses collègues, 2024, NEJM ; n = 1, SLA | Décodage textuel ; vocabulaire de 125 000 mots | Environ 32 mots/minute en conversation ; 97,5 % de mots corrects après entraînement supplémentaire | Précision textuelle, pas intelligibilité de voix directement synthétisée |
| Littlejohn et ses collègues, 2025, Nature Neuroscience ; n = 1, AVC | Voix en continu ; ensemble général de 1 024 mots | 47,5 mots synthétisés/minute ; traitement par intervalles de 80 ms | L’intervalle de traitement n’est pas le délai jusqu’au premier mot audible ; l’intelligibilité était évaluée par transcription des auditeurs |
| Wairagkar et ses collègues, 2025, Nature ; n = 1, SLA | Voix directe ; démonstration également de mots nouveaux | Environ 25 ms de délai audio ; près de 60 % des mots compris par les auditeurs | Aucun débit comparable unique cité ici ; démontrer des mots nouveaux ne prouve pas une précision illimitée |
| Card et ses collègues, 2026, Nature Medicine ; n = 1, SLA | Texte et commande de curseur ; vocabulaire de 125 000 mots | 56 mots/minute en moyenne ; plus de 99 % de mots corrects dans les tests sur consigne | 92 % des phrases quotidiennes jugées au moins majoritairement correctes par l’utilisateur ; mesure distincte de la précision des mots |
Sources du tableau : Card et ses collègues, 2024, Littlejohn et ses collègues, 2025, UC Davis sur Wairagkar et ses collègues, 2025 et Card et ses collègues, 2026.
La latence nécessite un point de départ et un point d’arrivée. Un intervalle de traitement décrit la fréquence d’actualisation du modèle. Le délai audio mesure la durée d’une chaîne de traitement. Le temps entre une consigne et la première sortie inclut en plus la réaction du participant et le début de sa tentative de parole. Dans l’étude de synthèse en continu de 2025, le délai médian entre la consigne et le début de la parole synthétisée était de 1,67 seconde pour le vocabulaire général. Réduire toute cette attente à 80 millisecondes serait faux. Figure 3 des données complémentaires.
Les mots par minute demandent eux aussi un contexte. L’étude en continu comparait un ensemble général de 1 024 mots à un ensemble limité de 50 phrases d’aide à la communication. Des phrases restreintes peuvent être plus faciles et plus rapides qu’une conversation libre. La taille du vocabulaire décrit le répertoire disponible, pas le nombre de mots démontrés comme également précis au quotidien. Définition des tâches et évaluation.
La précision peut désigner plusieurs choses. Le taux d’erreur sur les mots compte substitutions, omissions et ajouts par rapport à une transcription de référence. Une transcription par des auditeurs teste leur compréhension du son généré. Choisir la bonne phrase dans une courte liste est plus facile qu’écrire une parole inconnue sans choix proposés. L’étude vocale de Nature de 2025 comprenait les deux types de tests : ses excellents résultats de sélection de phrases ne doivent pas être présentés comme une parole libre parfaite. Nature : évaluation par l’écoute.
Le système textuel de 2024 offre un contraste utile : les NIH rapportaient environ 97,5 % de mots corrects après entraînement supplémentaire et un usage conversationnel à environ 32 mots par minute chez un participant. Ces chiffres décrivent une autre voie de décodage et une autre évaluation que l’expérience de voix directe de 2025. Attribuer cette précision à la démonstration vocale plus récente créerait un résultat qu’aucune étude n’a rapporté. NIH : l’étude de 2024.
COMMENT UNE VOIX FAMILIÈRE PEUT REVENIR
La voix porte l’identité autant que l’information. En reconstruire une version synthétique reconnaissable exige de distinguer ce que la personne veut dire de la sonorité souhaitée. Le décodeur neuronal fournit le signal de communication ; un modèle vocal personnalisé apporte des caractéristiques apprises dans des enregistrements.
Dans l’étude de synthèse en continu de 2025, un ancien enregistrement a aidé à rapprocher la sortie de la voix de la participante avant sa lésion. L’étude de synthèse vocale de Nature a également démontré un modèle personnalisé à partir d’enregistrements antérieurs à la SLA. Aucune approche n’a extrait une ancienne voix intacte d’un enregistrement caché dans le cerveau. Étude de la synthèse en continu, Nature : démonstration de voix personnalisée.
La personnalisation est une reconstruction. La ressemblance dépend des enregistrements disponibles et du modèle. Un timbre familier ne prouve pas que chaque détail d’accent, émotion ou habitude conversationnelle a été restauré. Il ne prouve pas non plus que les mots décodés sont corrects. Les patients devraient pouvoir choisir une voix recréée, une autre voix ou seulement du texte, et contrôler la réutilisation de leurs enregistrements vocaux.
UNE TENTATIVE DE PAROLE N’EST PAS LA PAROLE INTÉRIEURE PRIVÉE
Tenter de parler consiste à essayer d’exécuter l’acte de parole, même quand la paralysie empêche le mouvement ou le son attendu. La parole intérieure correspond à des mots vécus mentalement sans tentative d’articulation. Les deux peuvent sembler silencieuses à un observateur. L’expression « parole silencieuse » est donc trop ambiguë pour expliquer ce qu’une expérience demandait réellement.
La distinction existe, mais les signaux ne sont pas entièrement séparés. L’étude de Kunz et ses collègues publiée dans Cell en 2025 a enregistré quatre participants dont la parole était affectée par la SLA ou un AVC. Elle a observé dans le cortex moteur des représentations apparentées de la parole tentée et intérieure, avec des différences pouvant les distinguer. L’équipe a démontré un décodage volontaire de la parole intérieure et récupéré certains éléments verbaux lors de tâches structurées de comptage et de rappel de séquences. Étude de Cell, manuscrit en accès libre.
Cela ne démontre pas un accès illimité à la vie privée. Les recherches nécessitaient des capteurs implantés, des modèles propres aux participants et des tâches contrôlées. Elles montrent pourquoi la confidentialité ne peut pas reposer sur la promesse que le cortex moteur ne contient que des commandes volontaires. La parole intérieure n’est elle-même qu’une partie de la pensée ; souvenirs, sentiments et intentions abstraites ne sont pas interchangeables avec une phrase imaginée en mots.
Les NIH rapportent des taux d’erreur sur les mots de 14 % à 33 % dans la condition de parole intérieure à 50 mots, et de 26 % à 54 % avec un vocabulaire de 125 000 mots. Ces résultats dépendaient des conditions et des participants ; ce n’est pas une précision universelle de lecture des pensées. La cohorte totale comptait quatre personnes, mais chacune ne participait pas à toutes les expériences de décodage. NIH : explication de l’étude.
SEPTEMBRE 2026 : PAROLE ET GESTES À PARTIR D’UN IMPLANT
L’article de Brosler et ses collègues, publié dans Nature Neuroscience le 14 septembre 2026, a étudié trois participants au total. Les expériences de parole et de gestes simultanés en concernaient deux. Une grille ECoG par participant enregistrait des régions soutenant plusieurs mouvements, permettant à des décodeurs parallèles de piloter une sortie vocale et un avatar représentant le corps entier. Article original de 2026.
Les ensembles de communication étaient volontairement petits : cinq énoncés et quatre gestes pour un participant, dix énoncés et dix gestes pour l’autre. Il s’agissait d’options distinctes, pas d’une langue des signes libre ou de mouvements corporels quelconques. L’entraînement avec des comportements simultanés améliorait les performances lorsqu’ils se produisaient ensemble ; l’entraînement entre modalités réduisait aussi les activations non souhaitées.
C’est une preuve de concept pour une expression plus riche : un avatar peut associer une phrase à un geste communicatif. Cela ne signifie pas que l’implant a restauré le mouvement physique, décodé n’importe quel geste à la demande ou combiné une conversation libre à un corps virtuel complet. L’étape suivante consiste à fiabiliser ces sorties sur une gamme d’expressions bien plus vaste sans confondre les intentions.
QUI POURRAIT EN BÉNÉFICIER, ET POUR QUI CELA POURRAIT-IL NE PAS CONVENIR ?
Les données directes les plus solides présentées ici concernent des personnes atteintes de SLA ou d’un AVC du tronc cérébral dont l’expression orale est gravement altérée. La SLA peut endommager les voies motrices nécessaires à la parole. Un AVC du tronc cérébral peut interrompre la communication entre un cortex autrement fonctionnel et les muscles. Un décodeur peut contourner une partie de cette voie interrompue.
D’autres causes de paralysie sévère ou de trouble moteur de la parole pourraient être étudiées à l’avenir, si des signaux utilisables restent présents. C’est une possibilité de recherche, pas une garantie. Une personne qui ne parle plus parce que la formulation du langage est atteinte présente un problème différent de celle qui forme une phrase mais ne peut l’articuler.
On ne peut notamment pas supposer qu’une aphasie après un AVC cortical répondrait comme une paralysie après un AVC du tronc cérébral. Des changements cognitifs sévères, des régions cibles lésées, des risques de santé ou l’impossibilité de suivre l’entraînement peuvent modifier l’indication. Notre article sur Alzheimer et la perte de mémoire aide à comprendre pourquoi des maladies cérébrales différentes ne forment pas un unique problème technique.
Les méthodes existantes restent pertinentes : suivi du regard, contacteurs, tableaux de communication et appareils de synthèse vocale peuvent offrir un accès important sans chirurgie cérébrale. La question pratique est de savoir quelle approche donne à une personne le contrôle le plus fiable avec des contraintes acceptables. Un implant impressionnant n’est pas automatiquement le meilleur choix pour tous.
CHIRURGIE, ENTRAÎNEMENT ET VIE QUOTIDIENNE
L’implantation nécessite une neurochirurgie et une évaluation individuelle des risques d’infection, de saignement et de lésion tissulaire. Le matériel traversant la peau demande des soins ; composants implantés et connexions doivent rester fiables. Une séance d’enregistrement réussie ne prouve pas la sécurité à vie. Revue du domaine.
L’entraînement est une autre contrainte. Les participants peuvent répéter des phrases proposées pendant que les chercheurs ajustent les modèles, le rythme et les erreurs. La fatigue compte, surtout quand tenter de parler exige un effort. Les variations des signaux peuvent aussi imposer une recalibration. L’objectif est un système au service de la journée, pas une journée organisée autour de son entretien.
Un rapport de Nature Medicine du 15 juin 2026 a fait progresser cet objectif chez un homme atteint de SLA. Il documentait plus de 3 800 heures d’usage à domicile, avec l’aide de proches pour l’installation et sans nécessité de présence des chercheurs pendant l’usage autonome. Le débit moyen de communication était de 56 mots par minute. Les tests formels sur consigne dépassaient 99 % de mots corrects avec un vocabulaire de 125 000 mots ; le participant jugeait 92 % des phrases quotidiennes au moins majoritairement correctes. Ce sont des mesures différentes, et le temps enregistré comprend d’autres activités que la parole. Étude de 2026 sur l’usage à domicile.
C’est une preuve importante qu’une vie utile au-delà d’une démonstration supervisée est possible. Cela reste un résultat expérimental chez un seul participant. Il ne faut pas en faire une promesse de précision, d’autonomie ou de facilité d’installation identiques pour tous.
UNE INTERFACE PEUT-ELLE LIRE LES PENSÉES SANS AUTORISATION ?
Les interfaces de parole actuelles ne peuvent pas inspecter librement les pensées d’un inconnu. Elles dépendent d’un accès aux signaux cérébraux et d’un décodage spécialisé. Mais la volonté d’un utilisateur implanté de garder quelque chose privé ne constitue pas automatiquement une barrière physique pour le décodeur. Les résultats de 2025 sur la parole intérieure rendent concret ce risque plus limité.
Les chercheurs ont démontré des approches supprimant la sortie de parole intérieure dans un décodeur de parole tentée, ainsi qu’une activation volontaire par mot-clé d’une interface de parole intérieure. Les NIH rapportent une reconnaissance du mot-clé supérieure à 98 % dans le cadre testé. C’est prometteur pour le contrôle par l’utilisateur, pas une garantie contre toute activation accidentelle ou modification malveillante du logiciel. NIH : stratégies de protection de la vie privée.
Il faut distinguer la collecte d’un signal, l’inférence de mots et leur diffusion. Couper le haut-parleur ne traite que la dernière étape. Une conception respectueuse de la vie privée devrait rendre visible l’état actif, fournir une commande d’arrêt accessible et expliquer quels enregistrements neuronaux et transcriptions sont stockés, où s’effectue le traitement et qui accède aux données.
Ce sont des exigences de conception et des priorités éthiques, pas des fonctions démontrées dans toutes les interfaces expérimentales. L’utilisateur devrait décider si ses données peuvent entraîner de futurs systèmes, si sa voix synthétique peut être réutilisée et ce qui se passe lorsqu’il quitte un essai. Le consentement doit garder son sens après l’implantation. Pour le rôle social plus large de l’IA d’assistance, lisez Le Japon entre dans l’ère de l’IA au service des soins.
QUE FAUT-IL AMÉLIORER AVANT UN USAGE CLINIQUE ÉTENDU ?
Il faut d’abord reproduire les résultats. Les études doivent inclure davantage de participants, avec des maladies, accents, langues et degrés d’atteinte variés. Il faut établir qui en bénéficie ou non, et à quelle fréquence surviennent complications et échecs. Un résultat impressionnant chez une personne peut justifier d’autres essais sans répondre à ces questions.
La fiabilité doit couvrir la vie ordinaire : fatigue, interruptions, noms inconnus, conversations en arrière-plan, changements de posture et jours où les signaux sont médiocres. L’évaluation doit compter les sorties indésirables et le temps de correction autant que le débit maximal. Un moyen fiable de dire qu’un message était erroné fait partie de la communication ; ce n’est pas une option.
Le matériel doit devenir plus facile à vivre. Stabilité durable des signaux, installation gérable, connexions robustes et logiciels maintenables comptent autant qu’un score d’algorithme. Miniaturisation et systèmes sans fil sont des pistes importantes, mais supprimer les câbles ne prouve pas à soi seul des performances équivalentes et n’élimine pas les risques chirurgicaux.
Le déploiement clinique nécessite aussi des équipes formées, un soutien de rééducation, des solutions de réparation et un plan crédible de continuité après la fin d’un essai ou d’une entreprise. Coûts et prise en charge doivent être évalués avec les bénéfices. Un outil de communication ne devrait pas devenir inutilisable parce que l’équipe initiale n’est plus disponible.
VERS QUEL AVENIR POUR LA VOIX ISSUE DU CERVEAU ?
Les progrès démontrés comprennent la voix en continu, la modulation volontaire de l’expression vocale, les voix synthétiques personnalisées, une communication limitée associant parole et gestes et un usage autonome prolongé à domicile chez certains participants. Ces réalisations concernent des systèmes et des tâches différents. Aucune étude unique ne démontre toutes ces capacités ensemble.
Les possibilités futures incluent des tours de parole plus naturels, une expression plus riche, des répertoires gestuels plus vastes, un meilleur soutien multilingue et une transition fluide entre texte privé et conversation audible. Il faut les traiter comme des objectifs de développement. Leur valeur dépendra de leur capacité à préserver le sens voulu et à réduire l’effort quotidien.
Le test utile pour la prochaine génération est simple à formuler, même s’il est difficile à réaliser : peut-on commencer, interrompre, corriger et terminer une conversation quand on le choisit ? Retrouver une voix qui nous ressemble sans perdre le contrôle de nos mots ou enregistrements ? Garder un appareil utile dans une journée ordinaire difficile, pas seulement lors d’une démonstration préparée ?
La promesse de cette technologie réside dans ce pouvoir d’agir. Entendre une voix familière peut émouvoir, mais la réalisation plus profonde est de permettre à quelqu’un de décider quoi dire, quand le dire et quand garder le silence.
SOURCES ET PRÉCISIONS SUR LES PREUVES
Les articles originaux et les explications institutionnelles ci-dessous soutiennent les affirmations propres à chaque étude. Les années sont celles des publications ; les nombres de participants sont précisés. Cet article sépare résultats en direct, tâches expérimentales et possibilités futures. Certains articles de Nature ne donnent sans abonnement accès qu’au résumé, aux figures publiques ou aux compléments ; les synthèses des NIH et le manuscrit ouvert de Cell apportent un contexte accessible supplémentaire.
Wairagkar et ses collègues, Nature (2025) : synthèse vocale instantanée, un participant.
Card et ses collègues, Nature Medicine (15 juin 2026) : usage autonome à domicile, un participant.
NIH (2025) : une interface cerveau-ordinateur restaure une parole naturelle après une paralysie.
UC Davis (2025) : parole en temps réel, latence et intelligibilité pour les auditeurs.
NIH (2025) : décodage de la parole intérieure à partir de signaux cérébraux.
NIH (2024) : comment le cerveau produit la parole, cinq participants.
NIH (2024) : une interface cerveau-ordinateur aide un homme paralysé à parler.
Silva et ses collègues, Nature Reviews Neuroscience (2024) : revue sur les neuroprothèses de parole.
FAQ
Questions fréquentes
Un implant cérébral peut-il rendre la parole à toute personne qui ne parle plus ?
Non. Les résultats cités concernent des participants sélectionnés pour la recherche. L’adéquation dépend de la cause de la perte de parole, des signaux utilisables, de la possibilité d’une opération et de la capacité à entraîner puis utiliser le système. Ces dispositifs restent expérimentaux.
Une voix reconstruite par IA équivaut-elle au retour de la parole naturelle ?
Non. C’est un son synthétique produit par ordinateur, parfois personnalisé à partir d’anciens enregistrements. Il ne restaure pas les muscles ou les nerfs endommagés, et une voix familière peut encore contenir des erreurs de décodage.
Décoder une tentative de parole expose-t-il toutes les pensées privées ?
Non. Parole tentée et parole intérieure privée diffèrent, même si leurs motifs neuronaux peuvent se recouper. Les expériences contrôlées révèlent un risque limité pour la vie privée qui exige des protections délibérées, pas une lecture illimitée des pensées.
La newsletter PRESDA
Suivez l’actualité. Gardez une longueur d’avance.
L’essentiel de l’IA, du jeu vidéo, du sport, de l’économie, de l’actualité internationale, des célébrités et de l’art de vivre.